MCP e RAG: como conectar a IA aos dados que ela precisa
Data de publicação:
Compartilhar no LinkedIn (abre em uma nova aba)
Imagine desenvolver um assistente para uma loja virtual. Ele conversa bem, explica produtos e ajuda o cliente a escolher. Até que alguém pergunta:
Meu pedido já foi enviado? E como funciona a troca desse produto?
Para responder, o modelo precisa de informações que não estão necessariamente no seu treinamento: o estado atual de um pedido e a política de trocas daquela loja.
É nesse ponto que entram dois conceitos bastante presentes nas conversas sobre aplicações com inteligência artificial: MCP e RAG.
O MCP foi apresentado pela Anthropic em novembro de 2024 para padronizar a conexão entre aplicações de IA e fontes de dados ou ferramentas. Já o RAG ganhou uma formulação de referência em um artigo de 2020, combinando recuperação de informações com geração de texto. São respostas a problemas relacionados, mas diferentes. [1][2]
Em uma aplicação, podemos usar MCP para disponibilizar uma consulta de pedidos e RAG para buscar trechos da política de trocas antes de gerar uma resposta.
Para entender onde cada um se encaixa, vale começar por uma distinção: MCP é um protocolo. RAG é uma técnica. Nenhum dos dois é, por si só, um modelo de inteligência artificial.
O que é MCP?
MCP significa Model Context Protocol, ou Protocolo de Contexto de Modelo. Ele define uma maneira padronizada de aplicações de IA se comunicarem com sistemas externos. [3]
Pense nas integrações que um assistente pode precisar: consultar arquivos, acessar uma API, buscar informações em um repositório ou executar uma operação no sistema da empresa.
O protocolo oferece uma interface comum para expor essas capacidades a aplicações compatíveis. A implementação de cada integração continua existindo; o que passa a seguir um padrão é a comunicação com a aplicação de IA.
Quem participa dessa comunicação?
A arquitetura tem três participantes principais: [3]
- Host: a aplicação de IA que organiza a interação com o usuário e as conexões.
- Cliente MCP: o componente do host que se comunica com um servidor MCP.
- Servidor MCP: o programa que disponibiliza capacidades, executado localmente ou de forma remota.
Um servidor pode oferecer tools, funções executáveis; resources, conteúdos disponíveis para consulta; e prompts, modelos reutilizáveis de instruções. [4]
Voltando à loja, poderíamos disponibilizar uma ferramenta chamada consultarPedido. Ela receberia o identificador do pedido e retornaria os dados permitidos para aquele usuário.
O exemplo abaixo representa apenas o resultado dessa ferramenta:
{
  "pedidoId": "1234",
  "status": "enviado",
  "previsaoEntrega": "2026-10-10"
}
A aplicação entrega esse resultado ao modelo, que pode transformá-lo em uma resposta compreensível para o cliente.
Repare que existe código executando a consulta. O modelo não recebe acesso irrestrito ao banco: a ferramenta define a operação, e o sistema precisa validar os argumentos e as permissões.
MCP substitui uma API?
Uma API existente pode continuar sendo utilizada por trás do servidor MCP. Nesse cenário, o servidor adapta operações do sistema para que uma aplicação compatível possa descobri-las e solicitá-las pelo protocolo.
Também é possível integrar ferramentas diretamente à aplicação, sem MCP. O valor do padrão aparece especialmente quando queremos reutilizar uma integração em diferentes aplicações compatíveis.
O que é RAG?
RAG significa Retrieval-Augmented Generation, geralmente traduzido como geração aumentada por recuperação.
A ideia é recuperar informações relevantes de uma fonte externa e incluí-las no contexto usado pelo modelo para produzir uma resposta. Assim, a geração pode se apoiar em documentos e dados específicos do problema. [5]
No exemplo da loja, uma pergunta sobre troca pode ser respondida a partir da política publicada pela própria empresa.
O objetivo é buscar o conteúdo necessário para aquela pergunta, sem enviar todos os documentos disponíveis a cada interação.
Como esse processo funciona?
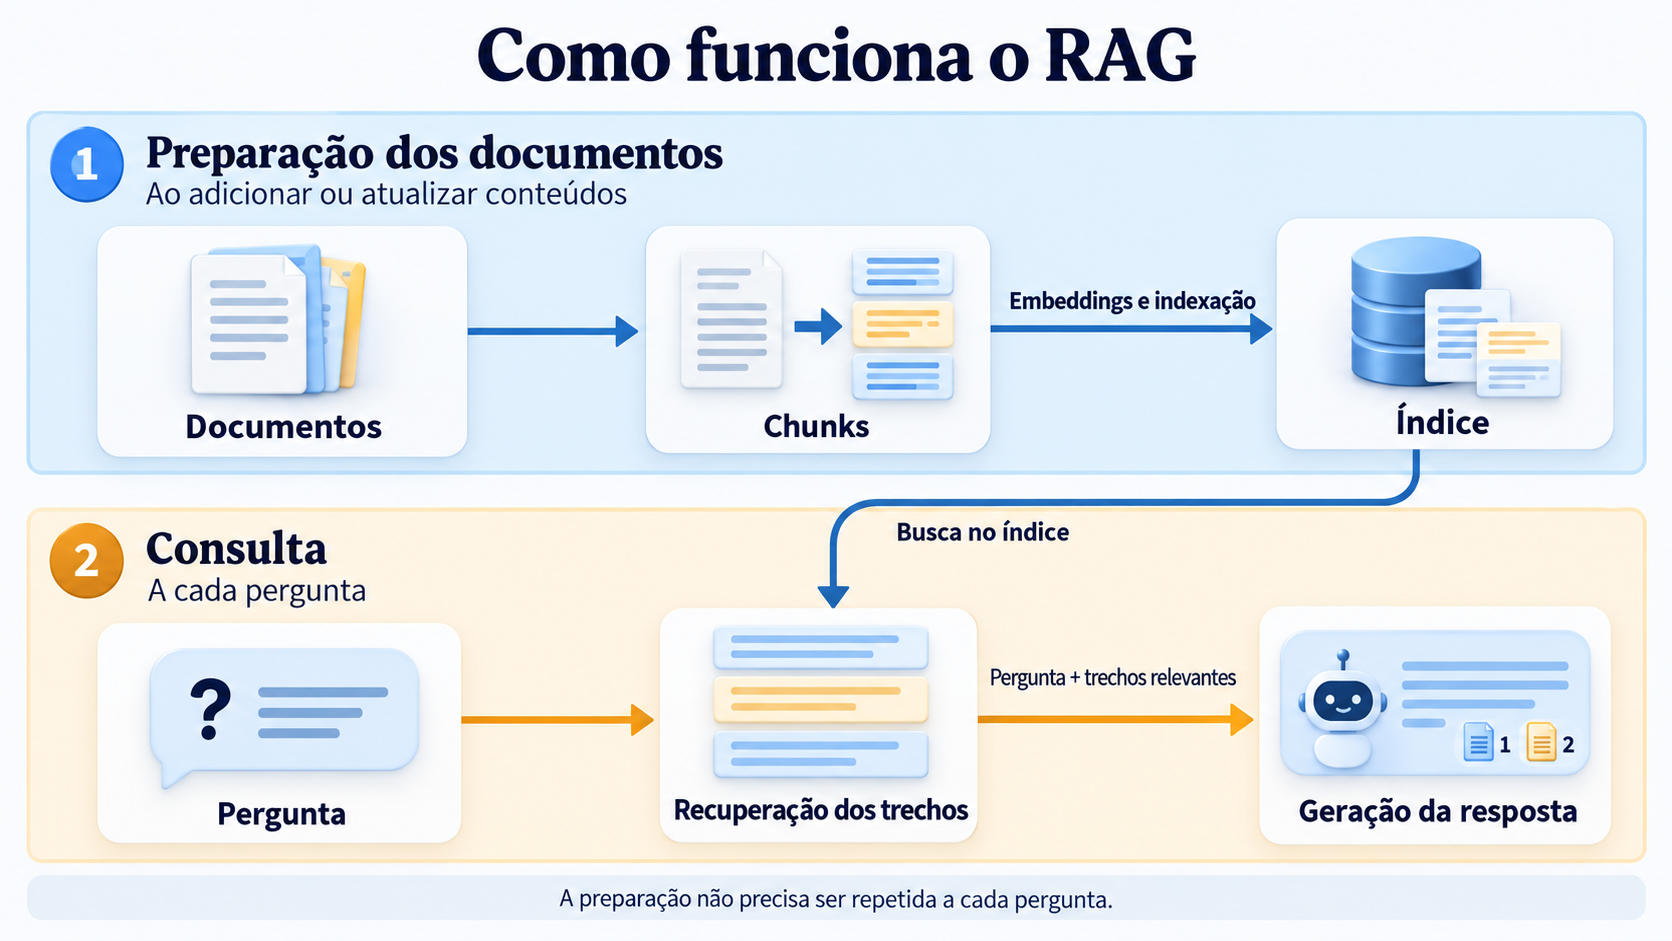
Em uma implementação comum com busca vetorial, existem dois momentos. A arquitetura apresentada pelo Google Cloud ajuda a visualizar essa separação. [6]
Primeiro, preparamos os documentos:
- Extraímos o conteúdo de páginas, arquivos ou outras fontes.
- Dividimos textos extensos em trechos, chamados de chunks.
- Geramos embeddings: representações numéricas usadas para comparar similaridade.
- Indexamos essas representações, mantendo a relação com os textos e suas fontes.
Depois, quando chega uma pergunta:
- Buscamos os trechos relevantes para a consulta.
- Incluímos os trechos selecionados no contexto do modelo.
- Pedimos uma resposta baseada nesse material, com referências às fontes utilizadas.
Por exemplo, alguém pode perguntar “posso devolver uma camiseta que não serviu?”, enquanto o documento usa a expressão “troca por tamanho”. Uma busca semântica pode ajudar a aproximar essas formas de falar do mesmo assunto.
Embeddings e bancos vetoriais são comuns, mas não definem sozinhos o RAG. A recuperação também pode usar busca por palavras-chave ou combinar métodos. O ponto central é recuperar informações para apoiar a geração. [5]
Isso significa treinar o modelo com meus documentos?
Usar RAG não exige atualizar os pesos do modelo a cada mudança nos documentos. O conteúdo recuperado é fornecido como contexto durante a resposta. [2][5]
Se a política da loja mudar, o sistema precisa atualizar a fonte e sua representação no mecanismo de busca.
Mesmo assim, RAG não garante uma resposta correta. Um trecho desatualizado, uma recuperação ruim ou uma interpretação equivocada ainda podem produzir erros.
Qual é a diferença entre os dois?
A comparação fica mais clara quando olhamos para a responsabilidade de cada um:
| Aspecto | MCP | RAG |
|---|---|---|
| O que é | Protocolo de comunicação | Técnica de recuperação e geração |
| Problema principal | Padronizar o acesso a capacidades externas | Apoiar respostas em informações recuperadas |
| Exemplo na loja | Disponibilizar a ferramenta de consulta de pedidos | Recuperar a política de trocas para responder |
| Exige busca vetorial? | Não | Não; é uma implementação comum |
| Depende do outro? | Não depende de RAG | Não depende de MCP |
Um servidor MCP pode expor uma ferramenta que busca documentos. Se os resultados forem usados para fundamentar uma resposta, essa ferramenta pode participar de um fluxo RAG.
Por outro lado, chamar uma calculadora por MCP não transforma a operação em RAG. Da mesma forma, um chatbot pode executar sua própria busca documental sem utilizar MCP.
Como, onde e por que utilizar?
Eu começaria pela pergunta que a aplicação precisa responder.
Ela precisa consultar documentos para explicar um assunto? RAG pode fazer sentido em centrais de ajuda, manuais de produtos e bases internas de conhecimento.
Ela precisa acessar ferramentas de diferentes sistemas por uma interface padronizada? MCP pode ajudar a disponibilizar essas capacidades para aplicações compatíveis.
Para tornar isso concreto, vamos ampliar o exemplo:
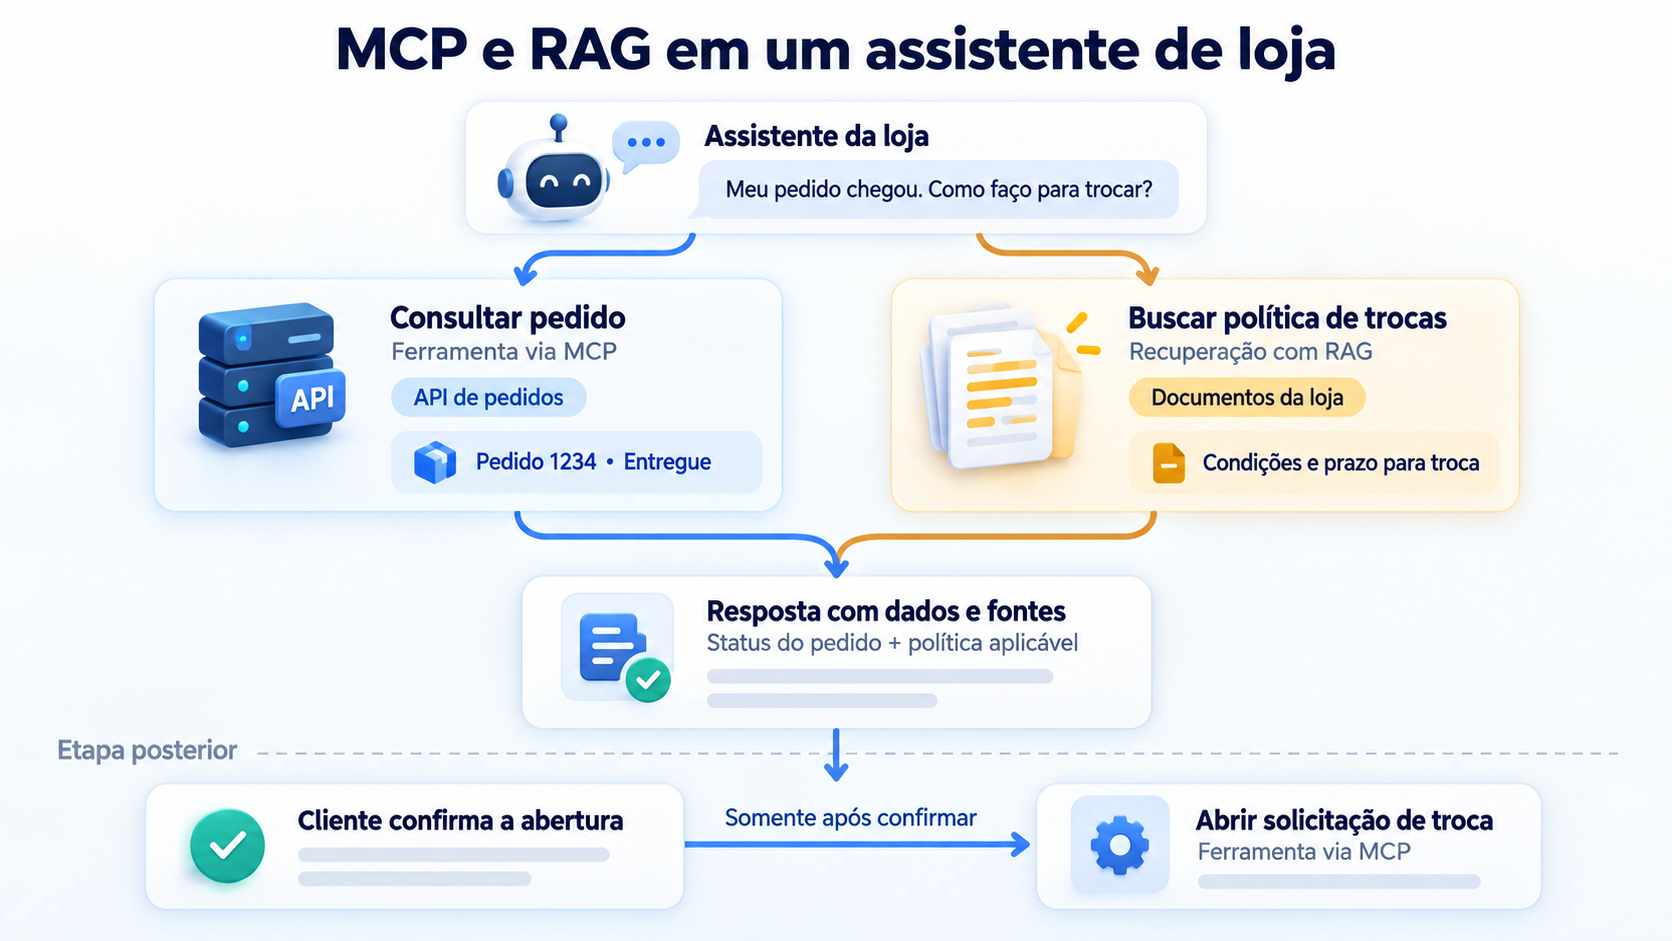
Meu pedido chegou com o tamanho errado. Posso trocar? Se puder, quero abrir uma solicitação.
Uma arquitetura possível seria:
- Consultar o pedido por uma ferramenta exposta via MCP.
- Recuperar a política aplicável por um fluxo RAG.
- Explicar as condições, indicando a fonte consultada.
- Confirmar os dados e a intenção do cliente.
- Executar uma ferramenta de abertura da solicitação, se autorizada.
Aqui, a busca ajuda a explicar as regras. Já as ferramentas consultam ou alteram o estado do sistema. A ferramenta de busca também poderia ser disponibilizada pelo próprio servidor MCP.
Como eu começaria em um projeto web?
Para esse exemplo, eu faria primeiro uma versão pequena: uma tela de chat, uma consulta de pedido e alguns documentos de teste.
Deixaria as credenciais e a validação de acesso no backend. Para a consulta, criaria uma operação específica, como consultarMeuPedido, em vez de permitir comandos livres sobre o banco.
Depois, testaria perguntas com respostas conhecidas: uma troca permitida, outra fora das condições e uma situação que os documentos não explicam. Nesse último caso, esperaria que o assistente reconhecesse a falta de informação.
Também separaria dois tipos de teste: a busca encontrou o trecho certo? A resposta respeitou esse trecho? Isso ajuda a localizar o problema quando o resultado parece convincente, mas está errado.
Final: entender o papel de cada peça
O que mais me interessa nessa combinação é como ela aproxima uma conversa com IA de um problema real de desenvolvimento.
Precisamos decidir de onde vêm os dados, quais operações estão disponíveis e como verificar se a resposta faz sentido.
MCP ajuda a padronizar as conexões. RAG ajuda a trazer informações relevantes para a geração. Eles podem trabalhar juntos, mas a escolha começa pela necessidade da aplicação.
No caso da loja, o resultado que eu buscaria é simples: um assistente capaz de consultar o pedido correto, explicar a política vigente e reconhecer quando não tem informação suficiente para continuar.
É isso que transforma uma resposta bem escrita em uma experiência útil.
Referências
- Anthropic — Apresentação do Model Context Protocol.
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, 2020.
- MCP — Documentação oficial: arquitetura.
- MCP — Documentação oficial: conceitos de servidor.
- Google Cloud — O que é Retrieval-Augmented Generation?.
- Google Cloud — Arquitetura de RAG com busca vetorial.